От рабочей памяти к Long Short-Term Memory: эволюция памяти в искусственных нейронных сетях
Аннотация
Память является фундаментальным компонентом как биологического познания, так и искусственной обработки информации. Ранние искусственные нейронные сети были ориентированы прежде всего на преобразование входных сигналов в выходные и не обладали механизмами сохранения информации во времени. Развитие рекуррентных нейронных сетей привело к появлению внутренних состояний, способных переносить информацию с предыдущих этапов обработки, обеспечивая искусственным системам простейшую форму временной памяти. Однако традиционные рекуррентные архитектуры столкнулись с существенными трудностями при обучении долговременным зависимостям, прежде всего вследствие проблем исчезающего и взрывающегося градиента.
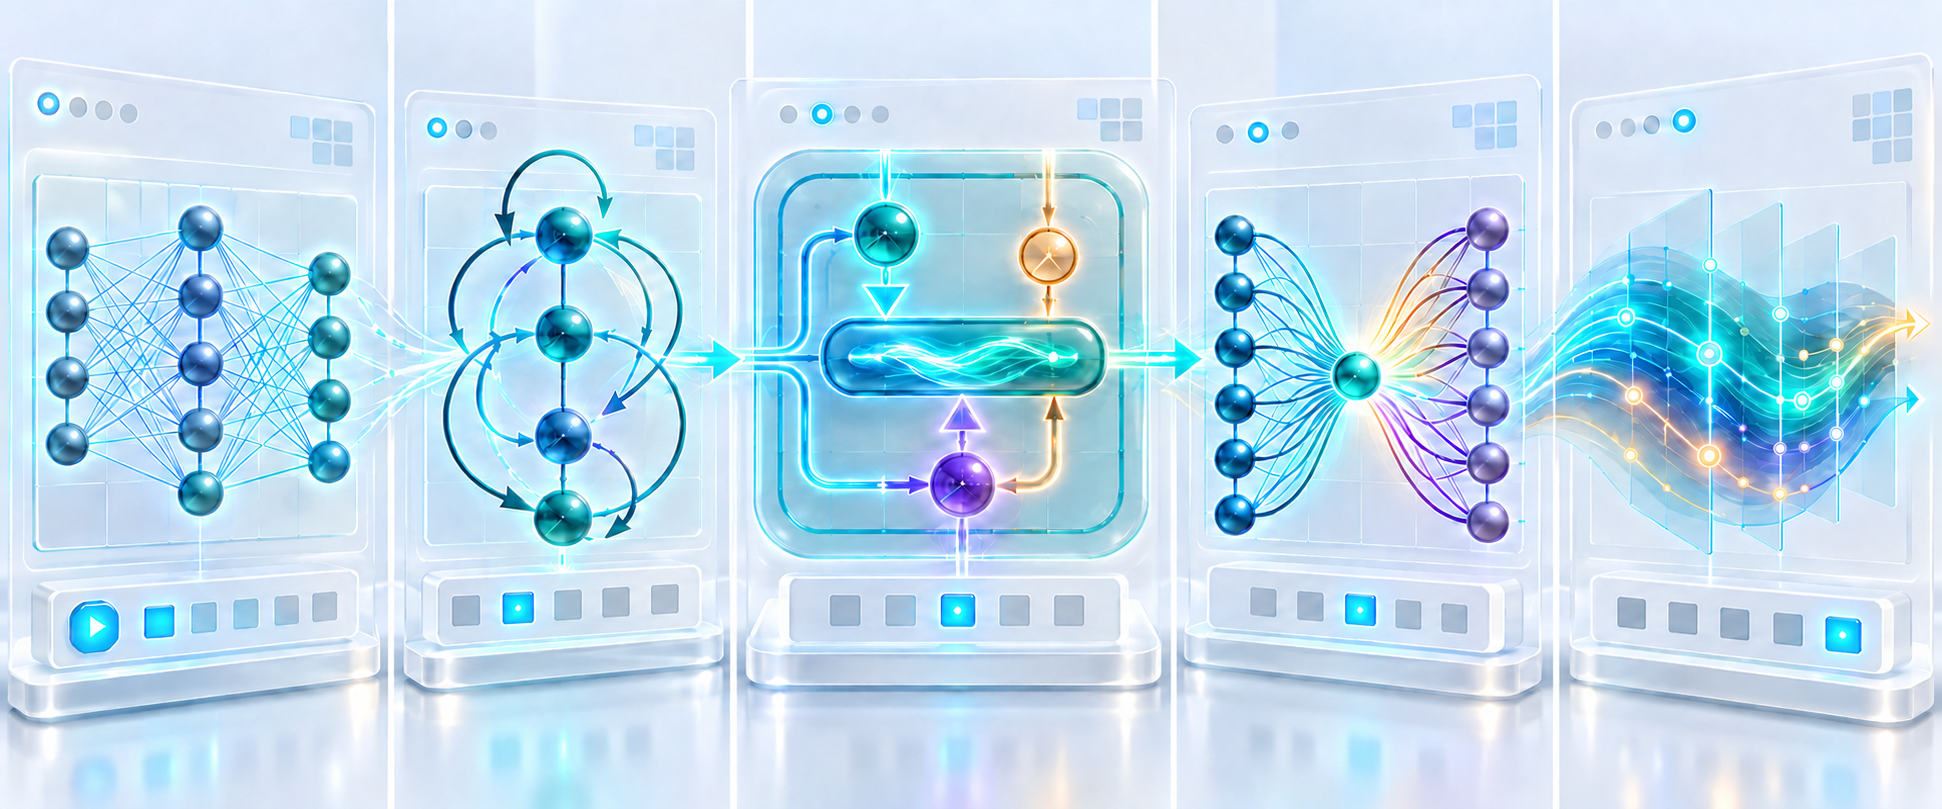
Появление архитектуры Long Short-Term Memory (LSTM), предложенной Зеппом Хохрайтером и Юргеном Шмидхубером в 1997 году, стало важным этапом развития механизмов памяти в нейронных сетях. Введение устойчивого состояния ячейки и механизмов управления сохранением, удержанием и извлечением информации позволило значительно эффективнее обучаться зависимостям, разделенным продолжительными временными интервалами. Последующие архитектуры, включая Gated Recurrent Unit (GRU), упростили механизмы рекуррентного управления, тогда как Transformers перенесли акцент обработки последовательностей на механизмы внимания. Более современные архитектуры пространства состояний, включая Mamba, вновь усилили интерес к эффективному сохранению и обновлению информации в длинных последовательностях.
В данной статье рассматривается историческое развитие механизмов памяти в искусственных нейронных сетях — от ранних сетей прямого распространения и рекуррентных архитектур до LSTM, GRU, Transformers и современных моделей пространства состояний. Особое внимание уделяется вычислительной проблеме сохранения информации во времени и архитектурным решениям, разработанным для преодоления ограничений ранних нейронных сетей. Эволюция этих систем показывает, как память постепенно превратилась в один из центральных элементов архитектур, предназначенных для обработки последовательной информации.
Ключевые слова: искусственные нейронные сети; память; рабочая память; рекуррентные нейронные сети; RNN; LSTM; Long Short-Term Memory; GRU; Transformer; внимание; модели пространства состояний; Mamba; исчезающий градиент; обработка последовательностей.
Введение
Искусственные нейронные сети первоначально разрабатывались как упрощённые вычислительные модели, вдохновлённые организацией биологических нервных систем. Их основной принцип был относительно прост: сеть получает информацию, преобразует её с помощью связанных между собой вычислительных элементов и формирует выходной сигнал. Такие системы оказались способны обучаться зависимостям между входными и выходными данными, однако ранние нейронные архитектуры имели существенное
ограничение — у них отсутствовал эффективный механизм сохранения информации о предыдущих событиях.
Для многих вычислительных задач это ограничение не является критическим. Например, при классификации статического изображения текущий входной сигнал может содержать большую часть информации, необходимой для получения ответа. Однако многие процессы реального мира по своей природе являются последовательными. Речь состоит из звуков, разворачивающихся во времени, значение языковых конструкций зависит от последовательности слов, действия человека образуют временные паттерны, а многие сигналы можно правильно интерпретировать только с учётом их предыдущих состояний.
В таких ситуациях независимой обработки каждого входного сигнала оказывается недостаточно. Система должна каким-либо образом сохранять информацию о том, что произошло раньше, и использовать её при обработке последующих событий. Иными словами, ей требуется определённая форма памяти .
Эта проблема сформировала одну из фундаментальных задач в развитии искусственных нейронных сетей: как нейронная сеть может сохранять значимую информацию во времени и одновременно отбрасывать сведения, которые больше не являются полезными?
Первым важным шагом к решению этой проблемы стало развитие рекуррентных нейронных сетей. В отличие от архитектур прямого распространения, рекуррентные сети содержат связи, позволяющие информации с предыдущих этапов обработки влиять на последующие. Благодаря этому у сети появляется внутреннее состояние, способное отражать определённые аспекты её недавней истории.
Однако одной только рекуррентности оказалось недостаточно для решения проблемы памяти. Теоретически обычные рекуррентные нейронные сети способны сохранять информацию на протяжении многих временных шагов, но на практике им часто трудно обучаться долговременным зависимостям. В процессе обучения влияние более ранних событий может постепенно ослабевать, из-за чего сети становится сложно устанавливать связь между событиями, разделёнными значительными временными интервалами.
Поиск решения этой проблемы в конечном итоге привёл к созданию архитектуры Long Short-Term Memory (LSTM) . Предложенная Зеппом Хохрайтером и Юргеном Шмидхубером в 1997 году, LSTM предоставила специализированный механизм для сохранения информации на протяжении длительных последовательностей. Вместо того чтобы полагаться исключительно на постоянно изменяющееся скрытое состояние, архитектура ввела отдельный путь памяти, содержимое которого могло сохраняться и контролироваться во времени.
Поэтому история LSTM является частью более широкой истории попыток наделить искусственные нейронные сети эффективной формой памяти. От ранних сетей прямого распространения к рекуррентным архитектурам, управляемым механизмам памяти, механизмам внимания и современным моделям пространства состояний центральная проблема остаётся удивительно похожей: определить, какую информацию необходимо сохранить, какую — обновить, а какую — забыть .
В данной статье это развитие рассматривается в исторической последовательности: как различные архитектуры нейронных сетей решали проблему памяти и почему каждый новый подход возникал в ответ на ограничения предыдущего.
До появления памяти: сети прямого
распространения
Первые искусственные нейронные сети не обладали памятью в современном вычислительном понимании. Информация проходила через сеть только в одном направлении: от входного слоя через один или несколько промежуточных слоёв к выходу. После обработки текущего входного сигнала сеть не сохраняла внутреннее представление предыдущих входов, которое могло бы непосредственно влиять на обработку следующего.
Такой принцип характерен для нейронных сетей прямого распространения ( feedforward neural networks ). Работу упрощённого нейронного слоя можно представить следующим образом:
где xx — входной сигнал, WW — обучаемые веса связей, bb — смещение, а ff — функция hh активации. Полученное состояние зависит от текущего входа, однако в выражении отсутствует отдельный компонент, представляющий предыдущее состояние сети.
Исторически этот подход восходит к одним из первых математических моделей искусственного нейрона. В 1943 году Уоррен Маккаллок и Уолтер Питтс предложили формальную модель, в которой нейроны представлялись простыми вычислительными элементами, способными объединять поступающие сигналы и формировать выход в соответствии с пороговым правилом. Их работа показала, что сети из упрощённых нейронов в принципе способны реализовывать логические операции.
Следующим важным шагом стал перцептрон Фрэнка Розенблатта, появившийся в конце 1950-х годов. Перцептрон мог изменять силу своих связей на основе предъявляемых примеров и поэтому представлял собой одну из ранних моделей обучающейся искусственной нейронной системы. Хотя его возможности были ограничены, сама идея имела фундаментальное значение: вместо явного программирования каждого правила некоторые свойства поведения системы могли формироваться посредством изменения весов связей.
Дальнейшее развитие многослойных нейронных сетей и распространение алгоритма обратного распространения ошибки ( backpropagation ) позволили обучать значительно более сложные зависимости между входными и выходными данными. Многослойная сеть могла постепенно формировать промежуточные представления входной информации и использовать их для решения задач классификации, распознавания и прогнозирования.
Однако такие сети по-прежнему в значительной степени рассматривали отдельные входные сигналы как независимые наблюдения. Представим последовательность:
Обычная сеть прямого распространения обрабатывает каждый её элемент приблизительно по одной и той же схеме:
Выход в момент времени tt определяется текущим входом x . Информация о xt−1x_{t-1}, ₜ xt−2x_{t-2} или более ранних событиях автоматически не сохраняется как часть внутреннего состояния сети.
Для статических задач этого может быть вполне достаточно. Например, классификатор изображений часто способен сформировать прогноз на основании информации, содержащейся в одном изображении. Однако обработка последовательностей предъявляет принципиально другое требование.
Рассмотрим предложение:
Ребёнок поднял стакан, потому что он был...
Интерпретация следующего слова зависит от информации, появившейся ранее в последовательности. Тот же принцип действует при обработке речи, музыки, движений, физиологических сигналов и временных рядов. Текущий сигнал зачастую невозможно правильно интерпретировать без информации о предшествующих событиях.
Одним из возможных решений является явная передача нескольких предыдущих наблюдений вместе с текущим входом. Однако такой подход не создаёт универсального механизма памяти. Число предыдущих состояний приходится задавать заранее, размер входного представления увеличивается вместе с временным окном, а зависимости, выходящие за его пределы, остаются недоступными.
Для более фундаментального решения требовалось изменить саму архитектуру сети. Вместо того чтобы обработать входной сигнал и сразу потерять сформированное при его обработке внутреннее состояние, сеть могла бы возвращать часть этого состояния самой себе и использовать его на следующем шаге.
Именно эта идея привела к появлению рекуррентных нейронных сетей .
Появление рекуррентных нейронных
сетей: сети Джордана и Элмана
Переход от сетей прямого распространения к рекуррентным нейронным сетям привнёс принципиально новую идею: сеть получила возможность использовать информацию, сформированную на предыдущих этапах обработки, при интерпретации текущего входного сигнала. Вместо того чтобы рассматривать каждое наблюдение как изолированное событие, система приобрела внутреннее состояние, изменяющееся во времени.
В упрощённой рекуррентной сети скрытое состояние можно представить следующим образом:
где x — текущий вход, h ₁ — скрытое состояние с предыдущего временного шага, WxW_x и ₜ ₜ₋ WhW_h — обучаемые матрицы весов, а h — новое скрытое состояние. ₜ
Принципиальным отличием от сети прямого распространения является появление h ₁. Теперь ₜ₋ текущее состояние сети зависит не только от информации, поступившей в данный момент, но и от информации, сформированной в прошлом.
Концептуально этот процесс можно представить так:
Каждое новое скрытое состояние содержит преобразованную комбинацию текущего входа и предыдущего состояния сети. В этом смысле рекуррентность создаёт вычислительный механизм сохранения истории последовательности.
Сети Джордана
Одной из важных ранних рекуррентных архитектур стала сеть, предложенная Майклом Джорданом в 1980-х годах. В сети Джордана информация с выходного слоя возвращается в специальные контекстные элементы. На следующем временном шаге эти элементы участвуют в обработке нового входного сигнала.
Упрощённо:
а обратная связь имеет вид:
Таким образом, сеть получает не только новый вход, но и информацию о собственном предыдущем выходе.
Такая архитектура имела особое значение для моделирования последовательного поведения, поскольку предыдущая реакция могла влиять на следующую. Сеть уже не просто преобразовывала отдельные входы в отдельные выходы: её текущее поведение начинало зависеть от собственной недавней активности.
Сети Элмана
Близкий, но чрезвычайно влиятельный подход был предложен Джеффри Элманом в 1990 году. Его Simple Recurrent Network (SRN) использовала другой источник обратной связи. Вместо предыдущего выходного сигнала в контекстные элементы передавалось предыдущее скрытое состояние сети.
Основной принцип можно записать как:
Таким образом, скрытое состояние в момент t − 1 становилось частью информации, используемой для вычисления состояния в момент tt.
Это небольшое на первый взгляд архитектурное изменение имело важные последствия. Скрытые представления могли содержать информацию, которая непосредственно не присутствовала на выходе сети. Благодаря этому сеть могла формировать внутреннее представление временного контекста и использовать его для прогнозирования или интерпретации последующих элементов последовательности.
Элман продемонстрировал этот принцип на последовательных языковых данных. Рекуррентная сеть, обучавшаяся предсказывать последующие слова, могла формировать внутренние представления, отражающие закономерности последовательности. При этом грамматические правила не задавались сети напрямую — информация о временной структуре возникала в процессе обучения на последовательностях.
Память как внутреннее состояние
Сети Джордана
и Элмана помогли сформировать принцип, ставший фундаментальным для рекуррентных нейронных вычислений: память может быть представлена в виде динамически изменяющегося внутреннего состояния .
Сети необязательно хранить предыдущие входные сигналы в виде их точных копий. Вместо этого информация о прошлых событиях может быть сжата и преобразована в скрытое представление:
Следовательно, h выполняет роль своеобразного обобщённого представления ₜ последовательности, обработанной к текущему моменту.
Это означает важный концептуальный переход. Сеть прямого распространения фактически отвечает на вопрос:
Что поступает на вход сейчас?
Рекуррентная сеть дополнительно получает возможность учитывать:
Что происходило раньше?
Однако вместе с появлением этой формы памяти возникла новая проблема. При каждом обновлении скрытого состояния предыдущая информация снова подвергается преобразованию. На коротких временных интервалах такой механизм может работать эффективно, однако в длинных последовательностях важная информация способна постепенно ослабевать или замещаться новой.
Таким образом, само наличие рекуррентных связей ещё не обеспечивало надёжной долговременной памяти. Объяснение того, почему обычным RNN трудно обучаться зависимостям между удалёнными событиями , стало следующей важной задачей.
Проблема долговременных зависимостей:
исчезающий и взрывающийся градиент
Рекуррентные нейронные сети создали механизм, благодаря которому информация о предыдущих состояниях могла влиять на последующую обработку. Теоретически это означало, что событие, произошедшее много шагов назад, способно повлиять на текущий выход сети. Однако на практике обычные рекуррентные сети столкнулись с серьёзными трудностями, когда требовалось обучаться связям между событиями, разделёнными большими временными интервалами.
Эта трудность получила название проблемы долговременных зависимостей ( long-term dependency problem ).
Представим последовательность, в которой информация, появившаяся в самом начале, становится необходимой значительно позже:
Если информация из x₁ необходима для правильной обработки x₅₀, сеть должна сохранить её значимое влияние на протяжении десятков рекуррентных преобразований.
Особенно заметной эта проблема становится во время обучения. Для обучения рекуррентных сетей обычно используется обратное распространение ошибки во времени ( Backpropagation Through Time, BPTT ). Концептуально рекуррентную сеть можно «развернуть» во времени:
Ошибка, вычисленная на более позднем шаге, распространяется назад по этой цепочке, чтобы определить, каким образом более ранние параметры сети повлияли на конечный результат.
При этом градиенты многократно умножаются на производные и матрицы весов, соответствующие последовательным временным шагам. В упрощённом виде влияние раннего состояния на более позднее содержит цепочку произведений:
Когда большое количество таких величин перемножается, могут возникнуть две противоположные проблемы.
Исчезающий градиент
Если значения, участвующие в последовательном умножении, преимущественно меньше единицы, градиент может быстро уменьшаться при распространении назад во времени:
После большого количества шагов градиент становится чрезвычайно малым. В результате события, произошедшие далеко в прошлом, практически перестают влиять на обновление параметров сети.
Это явление получило название проблемы исчезающего градиента ( vanishing gradient problem ).
Для сети это означает, что обучение краткосрочным зависимостям может происходить относительно успешно, тогда как освоение долговременных зависимостей становится значительно сложнее. Архитектура теоретически может сохранять влияние ранних состояний, однако алгоритм обучения уже не способен эффективно определить, как необходимо изменить эти ранние состояния для улучшения гораздо более позднего результата.
Взрывающийся градиент
Противоположная ситуация возникает, если при последовательном умножении появляются достаточно большие значения. Вместо стремления к нулю градиент начинает быстро увеличиваться:
Градиенты могут становиться чрезвычайно большими, вызывая нестабильное обновление параметров и затрудняя процесс обучения.
Это явление называется проблемой взрывающегося градиента ( exploding gradient problem ).
Хотя такие методы, как ограничение нормы градиента ( gradient clipping ), позволяют уменьшить практические последствия взрывающихся градиентов, проблема исчезающего
градиента представляла более фундаментальную трудность для обучения зависимостям на больших временных интервалах.
Почему долговременной памяти было трудно научиться
Таким образом, основная проблема заключалась не в том, что рекуррентные сети вообще не обладали памятью. У них существовало внутреннее состояние, способное переносить информацию с одного временного шага на следующий.
Проблема состояла в том, что такую память было трудно обучать на больших временных интервалах .
В обычной RNN такой обучающий сигнал должен пройти назад примерно через сто рекуррентных преобразований. Если градиент постепенно уменьшается, сеть фактически теряет возможность определить вклад далёкого события в последующий результат.
Эту проблему можно рассматривать как проблему назначения ответственности во времени ( temporal credit assignment ): какое из более ранних событий оказалось ответственным за результат, возникший значительно позже?
Хохрайтер и проблема долговременных зависимостей
Математические трудности обучения долговременным зависимостям в рекуррентных сетях подробно анализировались Зеппом Хохрайтером в его ранних работах по рекуррентным нейронным сетям. Уже в начале 1990-х годов становилась всё более очевидной проблема ослабления сигналов ошибки при их распространении через большие временные интервалы.
Дальнейшее теоретическое исследование Йошуа Бенжио, Патриса Симара и Паоло Фраскони , опубликованное в 1994 году, показало фундаментальные трудности обучения долговременным зависимостям градиентными методами в традиционных рекуррентных архитектурах.
Таким образом, задача становилась всё более определённой: рекуррентной сети требовался механизм, через который информация — и, что особенно важно, обучающий сигнал — могла бы проходить через множество временных шагов, не подвергаясь постоянному ослаблению в результате последовательных преобразований.
Для решения этой проблемы было недостаточно просто добавить рекуррентные связи. Требовалось изменить саму архитектуру таким образом, чтобы создать более стабильный путь передачи информации во времени.
Именно это требование в конечном итоге привело к появлению одной из наиболее влиятельных рекуррентных архитектур в истории нейронных сетей.
В 1997 году Зепп Хохрайтер и Юрген Шмидхубер представили Long Short-Term Memory — LSTM .
Следующий раздел уже центральный для всей статьи: “Long Short-Term Memory: A New Architecture for Neural Memory / Long Short-Term Memory: новая архитектура нейронной памяти” . В нём имеет смысл подробно разобрать исходную идею LSTM,
Long Short-Term Memory: новая
архитектура нейронной памяти
В 1997 году Зепп Хохрайтер и Юрген Шмидхубер предложили архитектуру Long Short- Term Memory (LSTM) , специально разработанную для решения проблемы обучения долговременным зависимостям в рекуррентных нейронных сетях.
Основная идея состояла не просто в увеличении размера или глубины рекуррентной сети. LSTM изменила сам способ сохранения информации во времени. В архитектуре появились специализированные ячейки памяти ( memory cells ), создававшие более стабильный путь передачи информации и сигналов ошибки через множество временных шагов.
Ячейка памяти
В обычной рекуррентной нейронной сети скрытое состояние постоянно преобразуется:
Таким образом, информация из прошлого на каждом временном шаге проходит через очередное нелинейное преобразование. В длинных последовательностях это затрудняет как сохранение значимой информации, так и передачу обучающего сигнала.
LSTM предложила другой принцип. Ячейка памяти содержала внутреннее состояние, предназначенное для сохранения информации во времени. В исходной архитектуре этот механизм был связан с концепцией, которую Хохрайтер и Шмидхубер назвали Constant Error Carousel (CEC) — «каруселью постоянной ошибки».
Основная идея заключалась в создании рекуррентной связи, производная которой могла оставаться постоянной. Вместо того чтобы позволять сигналу ошибки многократно умножаться на значения, приводящие к его исчезновению или взрывному росту, внутреннее состояние создавало путь для его более стабильного распространения.
Концептуально:
где C обозначает состояние ячейки памяти. ₜ
Это было принципиальным архитектурным изменением. Память переставала быть только косвенным следствием рекуррентности скрытого состояния и становилась специально организованным компонентом сети.
Управление доступом к памяти
Однако стабильное хранение создаёт следующую проблему. Если информация способна сохраняться в памяти длительное время, сети необходимо определить, когда новую информацию следует записывать и когда сохранённая информация должна влиять на дальнейшую обработку .
Поэтому в исходной архитектуре LSTM появились мультипликативные управляющие элементы — вентили ( gates ).
Особое значение имели два механизма:
· Input Gate — входной вентиль, определяющий, следует ли записывать новую информацию в ячейку памяти; · Output Gate — выходной вентиль, определяющий, должна ли сохранённая информация влиять на выход ячейки.
Для управления потоком информации используются сигмоидальные функции:
значения которых находятся между 0 и 1.
Значение, близкое к 0, способно практически перекрыть поток информации, тогда как значение, близкое к 1, позволяет ей проходить. Промежуточные значения обеспечивают частичную передачу.
Таким образом, вместо неконтролируемого рекуррентного сигнала LSTM получила механизм, способный обучаться тому, когда открывать и закрывать доступ к памяти .
От исходной LSTM к современной ячейке
Здесь важно сделать историческое уточнение. Архитектура LSTM, которую обычно изображают сегодня, не полностью совпадает с первоначальной версией 1997 года.
Исходная модель содержала ячейки памяти, входные и выходные вентили, а также механизм Constant Error Carousel. Хорошо известный сегодня Forget Gate — вентиль забывания — появился позднее в работах Феликса Герса, Юргена Шмидхубера и Фреда Камминса.
Forget Gate позволил сети непосредственно контролировать, какая часть предыдущего состояния памяти должна сохраняться:
Это сделало механизм памяти значительно более гибким. Вместо потенциально длительного сохранения информации сеть получила возможность обучаться целенаправленно уменьшать или удалять сведения, которые больше не нужны.
Поэтому современную ячейку LSTM можно представить через три основных вопроса:
Что необходимо забыть?
Какую новую информацию необходимо сохранить?
Какая информация должна стать доступной на выходе?
Этим вопросам соответствуют три наиболее известных компонента современной LSTM:
Forget Gate\text{Forget Gate}Input Gate\text{Input Gate}Output Gate.\text{Output Gate}.
Вместе с состоянием ячейки они образуют управляемую систему памяти.
Состояние ячейки
Центральным информационным путём современной LSTM является состояние ячейки (cell state) C . ₜ
Его обновление обычно записывают следующим образом:
где:
Эта формула достаточно точно отражает основную логику LSTM:
В отличие от скрытого состояния простой RNN, состояние ячейки способно обеспечивать сравнительно прямой путь передачи информации через множество временных шагов.
Почему появление LSTM было важным
LSTM изменила саму постановку проблемы. Вместо единственного вопроса:
Как сделать так, чтобы информация из прошлого влияла на настоящее?
появился более структурированный набор вопросов:
Что необходимо записать в память?
Как долго эту информацию следует сохранять?
Когда её необходимо использовать?
А последующее появление Forget Gate добавило ещё один принципиально важный вопрос:
Что необходимо забыть?
Именно это различие помогает понять значение LSTM. Главным нововведением была не просто рекуррентность, а появление обучаемого управления потоком информации через память .
Внутри ячейки LSTM: как осуществляется
управление памятью
Преимущество LSTM становится особенно понятным, если рассмотреть, что происходит внутри одной ячейки на отдельном временном шаге. В отличие от простой рекуррентной нейронной сети, LSTM не обновляет внутреннее представление посредством единственного преобразования. Вместо этого несколько взаимодействующих механизмов определяют, какую информацию необходимо удалить, какую — добавить и какая должна повлиять на текущий выход.
В момент времени tt LSTM получает три основных компонента:
x ,h ,C ,x_t,\qquad h_{t-1},\qquad C_{t-1}, t t−1 t−1 где x — текущий входной сигнал, h ₁ — предыдущее скрытое состояние, а C ₁ — предыдущее ₜ ₜ₋ ₜ₋ состояние ячейки памяти.
После этого выполняется последовательность управляемых операций.
1. Forget Gate: что необходимо сохранить?
Первая операция определяет, какая информация из предыдущего состояния памяти остаётся актуальной.
Forget Gate — вентиль забывания — вычисляется следующим образом:
Сигмоидальная функция формирует для каждого компонента памяти значение от 0 до 1.
Концептуально:
f ≈0 забыть,f_t\approx0 \Rightarrow \text{забыть},f ⇒ ≈1 сохранить.f_t\approx1 ⇒ t t \Rightarrow \text{сохранить}.
Предыдущее состояние памяти умножается на полученные значения:
Важно, что вентиль обычно не принимает простого бинарного решения. Его значения непрерывны, поэтому информация может сохраняться или подавляться в различной степени.
Таким образом, Forget Gate позволяет сети обучаться тому, какая информация должна сохраняться на протяжении многих временных шагов, а какая может постепенно исчезать.
2. Input Gate: что необходимо записать?
После определения того, что следует сохранить, LSTM решает, какая новая информация должна попасть в память.
Сначала Input Gate — входной вентиль — определяет интенсивность записи:
Одновременно сеть формирует новое состояние-кандидат:
CZ определяет, какая информация потенциально может быть добавлена, тогда как i ₜ ₜ определяет, какая её часть действительно будет записана.
Их совместный вклад:
Разделение содержания новой информации и механизма разрешения её записи является одним из характерных принципов управляемых рекуррентных архитектур.
3. Обновление состояния памяти
После этого старая и новая информация объединяются:
Это центральная операция памяти современной LSTM.
Её можно интерпретировать следующим образом:
Первый компонент определяет, что останется от прошлого. Второй — что будет добавлено из текущего входа.
Благодаря этому сети не требуется полностью перестраивать содержимое памяти на каждом временном шаге. Некоторые компоненты состояния ячейки могут оставаться относительно стабильными, тогда как другие избирательно изменяются.
4. Output Gate: что необходимо использовать сейчас?
Не вся информация, находящаяся в памяти, должна непосредственно влиять на текущий выход сети.
Output Gate — выходной вентиль — определяет, какие компоненты обновлённого состояния памяти будут участвовать в формировании скрытого состояния:
Новое скрытое состояние вычисляется как:
Cell State прежде всего обеспечивает относительно устойчивый путь памяти, тогда как Hidden State представляет ту информацию, которую ячейка делает доступной для текущей обработки и передачи другим компонентам сети.
Один шаг работы LSTM
Полную последовательность вычислений можно представить следующим образом:
Эти операции повторяются для каждого элемента последовательности:
Принципиально важно, что поведение вентилей обучается на данных . Программист не задаёт вручную правило о том, что конкретную информацию необходимо хранить десять шагов, а другую — удалить через два. Параметры, управляющие этими процессами, изменяются в ходе обучения сети.
Память как избирательный поток информации
Таким образом, ячейку LSTM можно рассматривать как систему управления потоком информации во времени.
Её компоненты отвечают на четыре взаимосвязанных вопроса:
Forget Gate: что из прошлого больше не требуется?
Input Gate: следует ли записать новую информацию?
Candidate State: какая новая информация доступна для сохранения?
Output Gate: какая часть текущей памяти необходима системе сейчас?
Такая организация обеспечивает LSTM значительно более управляемую форму временной памяти по сравнению с постоянно перезаписываемым скрытым состоянием простой RNN.
От LSTM к GRU: упрощение управляемой
памяти
Успех LSTM показал, что механизмы вентилей способны существенно улучшить способность рекуррентных нейронных сетей обучаться зависимостям во времени. Однако это преимущество сопровождалось увеличением вычислительной сложности. Ячейка LSTM содержит несколько отдельных преобразований для Forget, Input и Output Gates, а также для формирования нового состояния-кандидата. Поэтому LSTM требует большего количества параметров и вычислений, чем простая рекуррентная сеть.
Это поставило закономерный вопрос: можно ли сохранить основные преимущества управляемой памяти, используя более простую архитектуру?
Одним из наиболее влиятельных ответов стало появление в 2014 году Gated Recurrent Unit (GRU) , предложенной Кёнхёном Чо и его коллегами. GRU сохранила основной принцип управления потоком информации с помощью обучаемых вентилей, но упростила внутреннюю организацию рекуррентного блока.
Вместо трёх основных вентилей, характерных для современной LSTM, стандартная GRU использует два:
· Update Gate — вентиль обновления; · Reset Gate — вентиль сброса.
Ещё одно важное отличие состоит в том, что GRU не разделяет состояние ячейки C и скрытое ₜ состояние h , как это делает LSTM. Информация преимущественно представлена единым ₜ скрытым состоянием.
Update Gate: сколько информации из прошлого необходимо сохранить?
Update Gate определяет, насколько сильно предыдущее скрытое состояние должно сохраняться при формировании нового.
Его можно записать как:
Значение z регулирует соотношение между ранее сохранённой и вновь вычисленной ₜ информацией.
Концептуально Update Gate объединяет некоторые функции, которые в LSTM разделены более явно. Он помогает определить, должна ли сеть продолжить сохранять своё предыдущее представление или заменить его новой информацией.
Благодаря этому сеть получает относительно прямой механизм сохранения информации на протяжении нескольких временных шагов.
Reset Gate: какая информация из прошлого необходима сейчас?
Вторым механизмом является Reset Gate :
Reset Gate определяет, насколько сильно предыдущее скрытое состояние должно участвовать в формировании новой информации-кандидата.
Состояние-кандидат можно представить как:
Если отдельные компоненты r близки к нулю, соответствующие части предыдущего состояния ₜ оказывают минимальное влияние на новое представление. Таким образом, сеть может фактически игнорировать определённые аспекты своей истории, если они больше не нужны для обработки текущей информации.
Обновление скрытого состояния
Итоговое скрытое состояние объединяет предыдущее состояние и новое состояние- кандидат. В одном из распространённых вариантов записи:
Полную последовательность можно представить следующим образом:
В различных описаниях и программных реализациях можно встретить противоположное соглашение относительно коэффициентов Update Gate, однако основной принцип остаётся тем же: вентиль определяет баланс между старым состоянием и новым состоянием- кандидатом.
LSTM и GRU
Концептуально различие между двумя архитектурами можно представить так:
Таким образом, GRU представляет собой не отказ от принципа LSTM, а его упрощение. Обе архитектуры решают близкую задачу: позволяют рекуррентной сети обучаться тому, когда предыдущая информация должна сохраняться, а когда внутреннее представление необходимо изменить .
Нельзя утверждать, что одна из этих архитектур универсально превосходит другую. Их эффективность зависит от конкретной задачи, набора данных, структуры последовательностей, размера модели и условий обучения. Более простая архитектура GRU может давать преимущества за счёт меньшего количества параметров, тогда как LSTM предоставляет более явно разделённый механизм управления состоянием ячейки и её выходом.
В более широком историческом контексте переход от простой RNN к LSTM и GRU отражает важное изменение представлений о памяти в нейронных сетях. Память перестала рассматриваться только как результат рекуррентной активности. В архитектуру стали
непосредственно встраиваться механизмы управления сохранением и изменением внутренней информации .
Однако и LSTM, и GRU оставались принципиально рекуррентными архитектурами. Последовательность по-прежнему проходила через цепочку состояний:
Именно последовательная природа вычислений создавала следующее ограничение. Чтобы обработать поздний элемент последовательности, рекуррентной модели обычно приходилось передавать информацию через предыдущие временные шаги.
Вскоре получил распространение принципиально иной подход: вместо пошаговой передачи информации через рекуррентное состояние модель могла научиться непосредственно обращаться к релевантным элементам последовательности .
Эта идея привела к развитию механизмов attention , а затем — к появлению архитектуры Transformer .
От рекуррентности к вниманию: новый
подход к памяти последовательностей
Хотя LSTM и GRU значительно улучшили способность рекуррентных нейронных сетей сохранять информацию во времени, они сохранили фундаментальное свойство рекуррентных вычислений: последовательность преимущественно обрабатывалась через цепочку последовательно изменяющихся состояний.
В рекуррентной архитектуре информация от раннего элемента должна влиять на дальнейшую обработку через промежуточные состояния:
Даже если LSTM эффективно сохраняет значимую информацию, архитектура по-прежнему обрабатывает позиции последовательности последовательно. Это создаёт две важные проблемы.
Во-первых, отношения между удалёнными элементами всё ещё должны быть представлены посредством переходов между рекуррентными состояниями. Во-вторых, последовательный характер рекуррентных вычислений ограничивает возможности параллельной обработки при обучении: состояние в момент tt, как правило, зависит от состояния в момент t − 1.
Развитие механизмов attention — внимания — предложило другой принцип. Вместо необходимости сжимать всю значимую информацию из прошлого в единое изменяющееся рекуррентное состояние модель могла непосредственно определять, какие элементы последовательности наиболее важны для текущего вычисления.
Появление механизма внимания
Особое значение attention приобрёл в нейронном машинном переводе. Ранние модели типа encoder–decoder обычно использовали рекуррентный encoder для обработки входного предложения и сжатия его информации в представление фиксированной размерности. Затем decoder использовал это представление для генерации перевода.
Такой подход создавал информационное узкое место. Чем длиннее становилась последовательность, тем сложнее было представить всю необходимую информацию в одном векторе фиксированного размера.
В 2014 году Дмитрий Бахданау, Кёнхён Чо и Йошуа Бенжио предложили влиятельный подход к нейронному машинному переводу с использованием механизма внимания. Вместо того чтобы заставлять decoder опираться исключительно на одно итоговое представление входной последовательности, модель могла динамически назначать различные веса разным состояниям encoder.
Если encoder формирует:
decoder может построить контекстное представление:
где αt,i\alpha_{t,i} отражает значимость i-го состояния encoder при формировании выхода на шаге tt.
Таким образом, модели больше не требуется полагаться исключительно на информацию, переданную через последнее рекуррентное состояние. Она может избирательно обращаться к представлениям различных частей входной последовательности.
Это означало важное изменение в организации нейронной памяти.
От сохранения состояния к избирательному доступу
LSTM решает проблему памяти преимущественно посредством сохранения и изменения внутреннего состояния:
Attention вводит дополнительный принцип:
Теперь вместо единственного вопроса:
Какая информация должна оставаться внутри текущего состояния?
модель может также решать:
Какая из ранее представленной информации необходима для текущего вычисления?
Это принципиальное различие. Attention не просто создаёт более объёмную рекуррентную память — он изменяет способ доступа к информации.
Query, Key и Value
В дальнейшем механизм внимания получил более общую формулировку на основе трёх представлений:
· Query (Q) — какая информация требуется сейчас; · Key (K) — характеристика каждого доступного элемента, используемая для определения его релевантности; · Value (V) — информация, которая может быть извлечена.
Одна из наиболее известных форм — scaled dot-product attention :
Сходство между запросом и доступными ключами определяет веса внимания. Затем эти веса используются для объединения соответствующих значений.
Таким образом, модель получает механизм зависимого от содержания извлечения информации: разные элементы могут обращаться к разным частям представленной последовательности в зависимости от того, что является релевантным в данный момент.
Transformer
Решающая архитектурная перемена произошла в 2017 году, когда Ашиш Васвани и его коллеги представили Transformer в работе Attention Is All You Need .
Transformer
исключил рекуррентность из основного механизма обработки последовательности и стал опираться преимущественно на self-attention .
Вместо:
представление отдельного элемента могло формироваться посредством непосредственного обращения к другим элементам последовательности.
Упрощённо:
Self-Attention как контекстная память
При self-attention каждый элемент последовательности способен определять, какие другие элементы важны для формирования его представления.
Рассмотрим:
Для элемента x x_i модель вычисляет веса: i αᵢ₁, αᵢ₂, …, αᵢₙ
На итоговое представление сильнее всего влияют элементы, получившие большие веса внимания.
Таким образом, представление текущего элемента больше не определяется только его непосредственным предшественником или сжатой рекуррентной историей. Оно может напрямую зависеть от множества элементов, расположенных в разных частях доступного контекста.
Другая концепция памяти
Переход от LSTM к attention поэтому представляет собой не только изменение архитектуры нейронной сети. Он отражает изменение самого вычислительного принципа организации памяти.
Упрощённо:
LSTM делает акцент на сохранении информации во времени . Attention — на получении релевантной информации из доступного контекста .
Эти подходы не являются взаимоисключающими: первоначально механизмы внимания активно использовались совместно с рекуррентными сетями. Однако Transformer продемонстрировал, что мощную модель последовательностей можно построить и без рекуррентности как центрального механизма.
После этого основной вопрос снова изменился. Исследователи стали уделять всё больше внимания не только тому, как переносить состояние через время, но и тому, как хранить большие объёмы контекстной информации и эффективно получать к ней доступ .
После Transformer: модели пространства
состояний и Mamba
Успех Transformer принципиально изменил подход к моделированию последовательностей. Self-attention позволил непосредственно представлять отношения между удалёнными элементами и обеспечил высокую степень параллелизации при обучении. Однако этот подход создал новую вычислительную проблему: стоимость стандартного self-attention быстро увеличивается вместе с длиной последовательности.
Для последовательности из n элементов стандартный self-attention формирует взаимодействия между парами позиций. Поэтому его вычислительные требования и требования к памяти масштабируются приблизительно как:
Для относительно коротких последовательностей это может быть приемлемо. Однако если модель должна обрабатывать десятки или сотни тысяч элементов, количество попарных взаимодействий становится очень большим.
Это ограничение способствовало возрождению интереса к другому семейству методов обработки последовательной информации — моделям пространства состояний (State- Space Models, SSM) .
Модели пространства состояний
Общая идея модели пространства состояний появилась значительно раньше современных нейронных сетей. Подобные модели давно применяются в теории управления, обработке сигналов и исследовании динамических систем.
Основной принцип заключается в описании системы через внутреннее состояние, изменяющееся во времени.
В непрерывной форме линейную систему пространства состояний можно записать как:
где x(t)x(t) представляет входной сигнал, h(t)h(t) — внутреннее состояние системы, а y(t)y(t) — выход.
После дискретизации принцип можно представить следующим образом:
На первый взгляд это напоминает рекуррентную нейронную сеть: информация о предыдущих шагах сжимается в изменяющемся внутреннем состоянии.
Однако современные структурированные модели пространства состояний разрабатывались таким образом, чтобы сделать этот процесс вычислительно эффективным и одновременно сохранить способность моделировать долговременные зависимости.
Возвращение памяти в форме состояния
Развитие современных state-space архитектур особенно интересно с точки зрения истории нейронной памяти, поскольку в определённом смысле оно означает возвращение к старой идее.
RNN сохраняет информацию посредством скрытого состояния:
LSTM совершенствует этот процесс с помощью управляемой памяти:
Transformer
в значительной степени переносит акцент на непосредственный доступ к представлениям посредством attention:
Однако математические и вычислительные механизмы сохранения этого состояния существенно отличаются от классических RNN.
Такие архитектуры, как S4 (Structured State Space for Sequence Modeling) , продемонстрировали, что специально структурированные state-space системы способны моделировать очень длинные последовательности, сохраняя при этом привлекательные вычислительные свойства.
Проблема избирательности
Однако простая state-space система создаёт другую трудность. Если одинаковая динамика перехода состояния применяется независимо от содержания входного сигнала, возможности модели динамически определять значимость информации оказываются ограниченными.
И здесь мы снова возвращаемся к одной из центральных идей LSTM:
память должна быть избирательной.
Эффективная система памяти должна не просто сохранять информацию. Она должна определять, какие сведения являются значимыми, какие должны изменять внутреннее состояние, а какие можно игнорировать.
Этот принцип стал центральным для Mamba — селективной state-space архитектуры, представленной Альбертом Гу и Три Дао в 2023 году.
Mamba: селективная память пространства состояний
Mamba объединяет моделирование последовательностей посредством пространства состояний с зависящими от входа механизмами отбора информации .
Ключевая идея состоит в том, что параметры, управляющие эволюцией состояния, могут зависеть от текущего входного сигнала. Благодаря этому модель способна динамически определять, какая поступающая информация должна существенно изменить её внутреннее состояние.
Концептуально:
Таким образом, переход состояния не является полностью одинаковым для каждого входа. Текущая информация способна влиять на то, каким образом состояние будет обновлено.
Здесь возникает интересная концептуальная параллель с управляемыми рекуррентными сетями.
LSTM решает:
Что необходимо забыть?
Что необходимо записать?
Что необходимо передать на выход?
Mamba подходит к родственной проблеме через селективную динамику пространства состояний:
Какая входящая информация должна существенно изменить внутреннее состояние?
Селективное пространство состояний
В традиционной линейной модели пространства состояний такие параметры, как A, B и C, могут оставаться фиксированными для различных позиций последовательности. В Mamba важные компоненты вычислений пространства состояний становятся зависимыми от входа.
В упрощённом концептуальном виде:
Благодаря этому способ обработки информации может изменяться в зависимости от текущего токена или сигнала.
Одни входы способны существенно изменять внутреннее состояние, тогда как влияние других может быть сравнительно небольшим.
Именно поэтому понятие selective state-space model имеет принципиальное значение: архитектура вводит зависящий от содержания контроль над тем, какая информация поступает во внутреннее представление и изменяет его.
Память без явного attention
В отличие от стандартного Transformer, Mamba не требует построения полной матрицы внимания между всеми парами позиций последовательности.
Концептуально различие можно представить так:
для большого количества пар элементов, тогда как state-space модель поддерживает изменяющееся состояние:
Это позволяет основному механизму обработки последовательности в моделях типа Mamba масштабироваться линейно относительно её длины:
Такое свойство делает state-space архитектуры особенно интересными для обработки длинных последовательностей.
Историческое возвращение — но уже на новом уровне
С исторической точки зрения развитие архитектур образует почти замкнутый круг.
Ранние RNN пытались сжать прошлое в скрытое состояние.
LSTM добавила управляемые механизмы сохранения этого состояния.
Transformer
перенёс акцент с устойчивой рекуррентной памяти на непосредственный доступ к информации посредством attention.
Современные селективные state-space модели снова используют изменяющееся внутреннее состояние, однако объединяют этот принцип с более сложной математической организацией и зависимым от содержания отбором информации.
Историческую последовательность можно представить так:
Эта история представляет собой не простую последовательность замены старых архитектур новыми. Скорее, она показывает повторяющиеся попытки решить одну и ту же фундаментальную проблему:
Как нейронная система может сохранять значимую информацию, одновременно эффективн о отбрасывая или обходя нерелевантную?
Эволюция понятия памяти в
искусственных нейронных сетях
Историю искусственных нейронных сетей можно рассматривать не только как развитие всё более мощных вычислительных архитектур, но и как эволюцию представлений о том, как должна быть организована и управляться память .
Ранние сети прямого распространения практически не обладали внутренней временной памятью. Каждый входной сигнал преобразовывался в выход без специального механизма сохранения информации о предыдущих событиях:
Появление рекуррентных нейронных сетей изменило этот принцип. Архитектуры Джордана и Элмана ввели внутренний контекст, благодаря которому предыдущая активность сети могла влиять на последующую обработку:
Таким образом, память стала связываться с изменяющимся внутренним состоянием . Сеть больше не реагировала исключительно на текущий вход: её поведение могло зависеть и от недавней вычислительной истории.
Однако обычные рекуррентные сети выявили важное ограничение: наличие рекуррентного состояния само по себе ещё не означает способности эффективно сохранять и обучать значимую информацию на протяжении длительного времени. Проблемы исчезающего и взрывающегося градиента показали, что для долговременной памяти необходима не только рекуррентность, но и механизм, позволяющий сохранять информацию и обучающий сигнал через большие временные интервалы.
LSTM стала важным концептуальным переходом. Память превратилась в явно управляемый компонент архитектуры. Состояние ячейки обеспечивало относительно устойчивый информационный путь, а вентили определяли, какая информация должна сохраняться, записываться и становиться доступной для дальнейшей обработки. Последующее появление Forget Gate добавило явный механизм удаления устаревшей информации.
Основной принцип можно представить как:
GRU сохранила общую идею, одновременно упростив её реализацию. Несмотря на архитектурные отличия от LSTM, память по-прежнему представляла собой процесс избирательного балансирования между ранее сохранённой и новой информацией.
Механизмы attention привнесли следующее существенное изменение. Вместо необходимости сжимать всю значимую информацию в изменяющееся рекуррентное состояние сеть получила возможность избирательно обращаться к представлениям различных элементов доступной последовательности.
В Transformer этот принцип стал центральным. Память всё больше стала связываться не только с сохранением внутреннего состояния, но и с доступом к контексту, из которого релевантная информация может динамически извлекаться .
Современные state-space архитектуры, такие как Mamba, вновь делают акцент на изменяющемся внутреннем состоянии, однако объединяют этот принцип с зависящими от входа механизмами отбора и эффективной обработкой длинных последовательностей. Поэтому история нейронной памяти не представляет собой простого движения от рекуррентности к attention. Различные архитектуры предлагают разные решения нескольких тесно связанных задач: хранения, сохранения, отбора, обновления, извлечения информации и вычислительной эффективности.
Искусственная и человеческая память
Терминология нейронных сетей неизбежно вызывает аналогии с биологической памятью. Такие понятия, как memory cell , working memory , long-term memory , attention и forgetting , напоминают термины когнитивной психологии и нейронауки.
Однако такие аналогии необходимо использовать осторожно.
Состояние ячейки
LSTM не является непосредственной вычислительной моделью долговременной памяти человека, так же как скрытое состояние RNN нельзя напрямую отождествлять с человеческой рабочей памятью. Название Long Short-Term Memory прежде всего связано с вычислительной задачей, для решения которой была разработана
архитектура: обучением зависимостям через длительные временные интервалы при использовании рекуррентных состояний.
Человеческая память обеспечивается взаимодействием биологических систем, связанных с восприятием, вниманием, рабочей памятью, обучением, консолидацией, извлечением информации и различными формами долговременной памяти. Память искусственной нейронной сети, напротив, определяется математическими операциями над внутренними представлениями и параметрами модели.
Тем не менее между ними существует содержательная функциональная параллель .
И биологические, и искусственные системы сталкиваются с тем, что не вся доступная информация должна в одинаковой степени определять последующее поведение . Для эффективной обработки необходим отбор.
Одну информацию необходимо сохранять.
Другую — обновлять.
Третья должна становиться доступной в нужный момент.
А некоторая информация должна перестать влиять на дальнейшую обработку.
Именно эта функциональная проблема объединяет многие рассмотренные в статье архитектуры, несмотря на существенные различия между их механизмами и биологической памятью.
От хранения информации к управлению ею
Историческое развитие механизмов нейронной памяти можно представить как последовательный переход:
Таким образом, центральная проблема постепенно смещалась от простого хранения информации к управлению информацией .
Основной вопрос теперь заключается уже не только в том:
Как сохранить прошлое?
Но и в том:
Что именно из прошлого должно оставаться значимым, как это должно быть представлено и в какой момент эта информация должна влиять на настоящее?
Выводы
История развития памяти в искусственных нейронных сетях показывает, как одна из фундаментальных проблем обработки последовательностей постепенно
трансформировалась из задачи простого сохранения информации в проблему её избирательного и эффективного управления.
Ранние нейронные сети прямого распространения не обладали явным механизмом сохранения временного контекста. Появление рекуррентных архитектур позволило использовать внутреннее состояние, благодаря которому предыдущая активность сети могла влиять на последующие вычисления. Сети Джордана и Элмана продемонстрировали, что рекуррентные связи способны обеспечивать искусственной нейронной системе представление о недавней истории. Однако проблемы исчезающего и взрывающегося градиента показали, что одной рекуррентности недостаточно для надёжного обучения зависимостям на больших временных интервалах.
Появление Long Short-Term Memory (LSTM) , предложенной Зеппом Хохрайтером и Юргеном Шмидхубером в 1997 году, стало важнейшим шагом в решении этой проблемы. Использование ячеек памяти и управляемого потока информации позволило создать более устойчивый механизм сохранения зависимостей во времени. Последующее развитие архитектуры, в частности появление Forget Gate, превратило LSTM в гибкую систему, способную избирательно сохранять, обновлять, забывать информацию и предоставлять её для дальнейшей обработки.
Разработка GRU показала, что аналогичные принципы могут быть реализованы в более простой управляемой архитектуре. Механизмы attention и последующее появление Transformer предложили принципиально другой подход: вместо необходимости постоянно переносить значимую информацию через рекуррентное состояние модель получила возможность непосредственно обращаться к различным элементам доступного контекста. Современные state-space архитектуры, включая Mamba , продолжили эту линию развития, объединив эффективную обработку последовательностей посредством внутреннего состояния с механизмами отбора, зависящими от входной информации.
Таким образом, в искусственных нейронных сетях не существует единственного вычислительного механизма, который можно было бы однозначно назвать «памятью». Она может быть представлена рекуррентным состоянием, управляемым состоянием ячейки, доступным контекстом, механизмом внимания или селективной динамикой пространства состояний. Каждая из этих архитектур по-своему решает одну общую проблему: как сохранить полезную информацию и одновременно не позволить нерелевантной информации определять последующие вычисления .
При этом искусственную нейронную память не следует непосредственно отождествлять с рабочей или долговременной памятью человека. Используемая терминология отражает прежде всего функциональные аналогии, а не биологическую эквивалентность. Тем не менее биологические и искусственные системы обработки информации сталкиваются с общей функциональной задачей: информацию необходимо отбирать, сохранять, обновлять, извлекать и в некоторых случаях забывать.
С этой точки зрения путь от простых рекуррентных сетей к LSTM, Transformer и современным моделям пространства состояний можно рассматривать как непрерывный поиск всё более эффективных механизмов избирательной памяти . Поэтому история нейронной памяти — это не просто история увеличения продолжительности хранения информации. Это история развития способности системы определять, что необходимо запомнить, что следует забыть и какая информация должна стать значимой в конкретный момент времени .
- McCulloch, W. S., & Pitts, W. (1943). A logical calculus of the ideas immanent in nervous activity. The Bulletin of Mathematical Biophysics, 5 , 115–133.
- Rosenblatt, F. (1958). The perceptron: A probabilistic model for information storage and organization in the brain. Psychological Review, 65 (6), 386–408.
- Rumelhart, D. E., Hinton, G. E., & Williams, R. J. (1986). Learning representations by back-propagating errors. Nature, 323 , 533–536.
- Jordan, M. I. (1986). Serial Order: A Parallel Distributed Processing Approach . Institute for Cognitive Science, University of California, San Diego.
- Elman, J. L. (1990). Finding structure in time. Cognitive Science, 14 (2), 179–211.
- Bengio, Y., Simard, P., & Frasconi, P. (1994). Learning long-term dependencies with gradient descent is difficult. IEEE Transactions on Neural Networks, 5 (2), 157–166.
- Hochreiter, S., & Schmidhuber, J. (1997). Long short-term memory. Neural Computation, 9 (8), 1735–1780.
- Gers, F. A., Schmidhuber, J., & Cummins, F. (2000). Learning to forget: Continual prediction with LSTM. Neural Computation, 12 (10), 2451–2471.
- Cho, K., van Merriënboer, B., Gulcehre, C., Bahdanau, D., Bougares, F., Schwenk, H., & Bengio, Y. (2014). Learning phrase representations using RNN encoder–decoder for statistical machine translation. Proceedings of EMNLP 2014 , 1724–1734.
- Bahdanau, D., Cho, K., & Bengio, Y. (2015). Neural machine translation by jointly learning to align and translate. International Conference on Learning Representations (ICLR) .
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 30 .
- Gu, A., Goel, K., & Ré, C. (2022). Efficiently modeling long sequences with structured state spaces. International Conference on Learning Representations (ICLR) .
- Gu, A., & Dao, T. (2023). Mamba: Linear-time sequence modeling with selective state spaces. arXiv preprint arXiv:2312.00752 .